
اگر تولید گزارش یا پردازش فایل بیش از زمان قابلتحمل درخواست HTTP طول میکشد، صفِ پایدار میتواند دریافت کار را از اجرای آن جدا کند. اما async کردن یک تابع، کار CPU سنگین را خودکار به پسزمینه نمیبرد؛ گذاشتن کار در یک آرایهٔ حافظه هم صف پایدار نیست. قبل از انتخاب ابزار، قرارداد نتیجه، خطا و اجرای دوباره را روشن کنید.
۱. چه چیزی واقعاً طولانی است؟
| نوع کار | مسئلهٔ اصلی | جهت بررسی |
|---|---|---|
انتظار API یا فایل |
زمان انتظار و timeout |
I/O غیرمسدودکننده و محدودیت همزمانی |
محاسبهٔ CPU سنگین |
اشغال Event Loop |
تقسیم کار یا پردازش مناسب خارج از مسیر اصلی |
| کار قابلپیگیری و طولانی | قطع درخواست و نیاز به نتیجهٔ بعدی | صف پایدار و worker |
این انتخابها جای هم نیستند. تابع async میتواند هنوز محاسبهٔ سنگین همگام اجرا کند و پاسخ درخواستهای دیگر را عقب بیندازد. صف هم بدون ظرفیت worker، محدودیت نرخ و backpressure فقط انباشت کار را جابهجا میکند.
۲. قرارداد معمول دریافت تا نتیجه
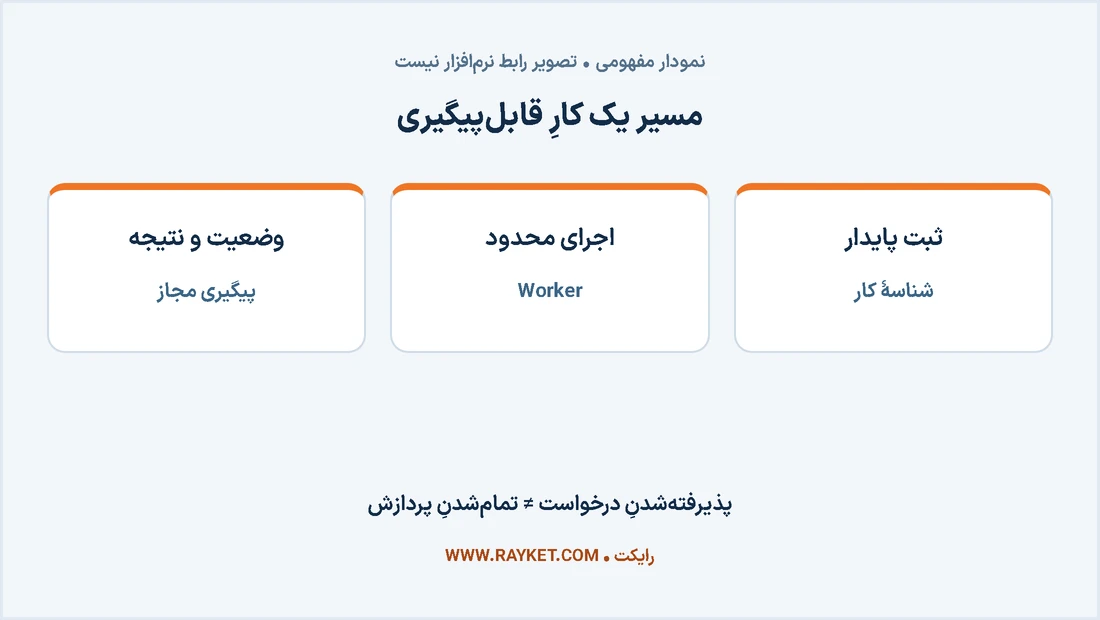
- درخواست معتبر و مجاز دریافت میشود.
- رکورد کار بهصورت پایدار ثبت و شناسهٔ آن تعیین میشود.
- پذیرفتهشدنِ کار به کاربر اعلام میشود؛ نه تمامشدن آن.
- worker کار را با منابع محدود انجام میدهد.
- وضعیت و نتیجهٔ مجاز از مسیر پیگیری قابلدسترسی میشوند.
کد202 یکی از قراردادهای متداول برای پذیرش کارِ هنوز تمامنشده است، ولی باید با API شما و روش مشاهدهٔ نتیجه سازگار باشد. پاسخ موفق پیش از ثبت پایدار کار، میتواند در قطع فرایند به گمشدن درخواست منجر شود.
۳. retry بدون idempotency کافی نیست
اگر worker بعد از اثر خارجی ولی قبل از ثبت موفقیت قطع شود، کار ممکن است دوباره اجرا شود. برای گزارش ساده شاید دوبارهسازی فقط هزینه داشته باشد، اما برای ایمیل یا عملیات مالی پیامد متفاوت است. طراحی باید اثر اجرای مجدد را محدود کند.
نمونهٔ زیر فقط مفهوم جلوگیری از تکرار در حافظه را نشان میدهد و برای تولید کافی نیست:
const results = new Map();
function handle(job) {
  if (results.has(job.key)) return results.get(job.key);
  const result = { reportId: 'demo-report' };
  results.set(job.key, result);
  return result;
}
const job = { key: 'demo-1' };
console.log(handle(job) === handle(job), results.size);
خروجی واقعی true ۱ بود. با restart، Map از بین میرود؛ در چند فرایند هم مشترک نیست. این مثال atomicity دیتابیس، race یا اثر خارجی را حل نمیکند. در تولید، قید یکتا، تراکنش و قرارداد idempotency مقصد باید جدا طراحی شوند.
۴. سیاست خطا و مصرف منابع
- خطای موقتی و ورودی نامعتبر را از هم جدا کنید.
- تعداد تلاش و backoff محدود داشته باشید؛ retry فوریِ نامحدود فشار میسازد.
- برای کار شکستخورده وضعیت قابلبررسی و مسئول رسیدگی تعیین کنید.
- حجم payload، concurrency و عمر نتیجه را محدود کنید.
- لغو کار و timeout را با وضعیت اثرِ ایجادشده هماهنگ کنید.
در مستند BullMQ، retry و backoff قرارداد مشخص دارند؛ این مقاله فقط اصول را توضیح میدهد و نصب Redis یا BullMQ را انجام نمیدهد. نام یک کتابخانه تضمین دقیقاًیکبار بودن اثرِ همهٔ سرویسهای بیرونی نیست.
۵. هاست شما چه ظرفیتی دارد؟
پیش از طراحی نهایی بپرسید worker دائمی، broker، اتصال موردنیاز و سقف منابع در محیط مقصد مجاز و قابلنگهداری هستند یا نه. توان اجرای اپلیکیشن وب در سیپنل لزوماً به معنی اجازهٔ هر سرویس پسزمینهای نیست. مشخصات واقعی پلن و پاسخ پشتیبانی را مبنا بگذارید.
نکته: این مقاله صف یا Cron فعال نمیکند و هیچ درخواست، ایمیل یا پرداخت واقعی در آزمون آن ساخته نشده است. نمونهٔ Map فقط رفتار دو فراخوان محلی روی دادهٔ آموزشی را نشان میدهد.
۶. معیار تصمیم
وقتی پاسخ باید سریع برگردد، کار قابلیت پیگیری دارد، حفظ آن پس از قطع فرایند مهم است و توان نگهداری worker فراهم است، بررسی صف منطقی میشود. اگر کار کوتاه و ساده است، زیرساخت اضافه ممکن است هزینهٔ نگهداری بیدلیل بسازد. تصمیم نهایی را با اندازهگیری زمان، محدودیت واقعی هاست و طراحی بازیابیِ کار ثبت کنید.
۷. مسیر مطالعهٔ مرتبط
۸. منابع و روش بررسی
منابع رسمی در ۲۴ اکتبر ۲۰۲۶ بررسی شدند. مثالهای کدِ این متن در Node.js نسخهٔ ۲۴.۱۹.۰ روی محیط محلی ایزوله بررسی شدهاند؛ نصب روی هاست، اتصال دیتابیس یا کارایی تولید با این آزمایش اثبات نشده است.