
برای شمارش رخدادهای مشابه در فایل متنی، معمولاً باید دادهٔ مناسب را استخراج، مرتب و سپس با uniq -c تجمیع کنید. uniq فقط تکرارهای مجاور را میشناسد؛ اجرای آن روی لاگ نامرتب میتواند آمار گمراهکننده بدهد. این آموزش با یک فهرست کوچک کد پاسخ، منطق شمارش را روشن میکند.
۱. ابتدا واحد شمارش را مشخص کنید
در نمونهٔ ما، فایل codes.txt فقط این شش خط را دارد؛ هر خط یک کد پاسخ آموزشی است، نه لاگ کامل وبسرور:
200
404
200
503
200
404
در لاگ واقعی، تاریخ، URL، شناسه و متن خطا میتوانند در هر خط فرق کنند. اگر کل خط را تجمیع کنید، تقریباً هر رخداد یکتا میشود. ابتدا مشخص کنید میخواهید کد پاسخ، مسیر یا نوع خطا را بشمارید؛ قالب Apache، JSON و لاگ سفارشی روش استخراج یکسانی ندارند.
۲. شمارش تکرارهای غیرمجاور
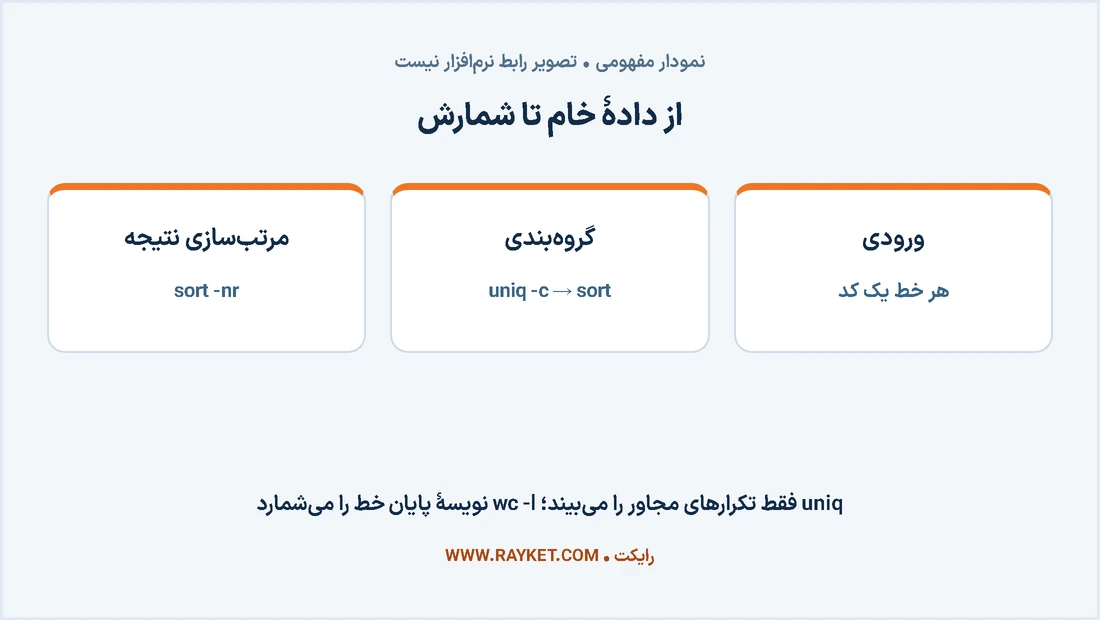
LC_ALL=C sort codes.txt | uniq -c | sort -nr
sort اول، کدهای یکسان را کنار هم میآورد؛ uniq -c تعداد هر گروه را اضافه میکند؛ sort -nr عدد ابتدای خط را نزولی مرتب میکند. خروجی واقعی نمونه:
3 200
2 404
1 503
فاصلههای ابتدای خروجی ممکن است بیشتر باشند، ولی عددها همیناند. LC_ALL=C در این فرمان ترتیب مقایسه را ثابتتر میکند؛ این انتخاب برای مرتبسازی متن فارسی معیار زبانشناختی مناسبی نیست.
۳. تعداد خط، کلمه و بایت متفاوت است
wc -l -- codes.txt
wc -l -- no-final-newline.txt
wc -l تعداد نویسهٔ پایان خط را میشمارد. فایل نمونهٔ دوم شامل alpha، یک newline و beta بدون newline نهایی بود؛ نتیجه۱ شد، هرچند در ویرایشگر دو ردیف میبینید. برای آمار، شرط «هر رخداد یک خط پایانیافته» باید برقرار باشد.
| گزینه | چه میشمارد |
|---|---|
wc -l |
تعداد newline |
wc -w |
واژههای جداشده طبق قواعد ابزار/locale |
wc -c |
بایتها |
wc -m |
نویسهها در locale مناسب |
یک حرف فارسی در UTF-۸ میتواند بیش از یک بایت باشد؛ تعداد بایت را با تعداد حرف یا رخداد برابر نگیرید.
۴. دامهای آمار ظاهراً دقیق
- uniq بدون sort فقط گروههای متوالی را میبیند.
- sort معمولی متن را مرتب میکند؛ برای عدد، -n لازم است.
- شمارش کل خطِ دارای timestamp، شمارش نوع خطا نیست.
- دادهٔ ناقص، فایل چرخیده یا چند لاگ موازی میتواند مخرج آمار را عوض کند.
- تعداد درخواست برابر تعداد بازدیدکننده یا تعداد حمله نیست.
نکته: افزودن IP به گزارش میتواند دادهٔ شخصی تولید کند. اگر صرفاً فراوانی خطا لازم است، IP و پارامترهای URL را وارد مجموعهٔ خروجی نکنید.
۵. اعتبارسنجی گزارش
- چند ردیف ورودی را با چشم بخوانید و قالب را تأیید کنید.
- مجموع شمارش گروهها را با تعداد رکوردهای مورد انتظار مقایسه کنید.
- بازهٔ زمانی، منبع فایل و فیلترهای استفادهشده را کنار نتیجه بنویسید.
- نتیجهٔ غیرعادی را با لاگ خام محدود و نمودار منابع تطبیق دهید.
برای همین نمونه، مجموع ۳+۲+۱ برابر۶ است. این کنترل ساده، انتخاب اشتباه فیلد یا جاافتادن بخشی از ورودی را آشکار میکند. در فایلهای بزرگ sort میتواند CPU، حافظه و فضای موقت مصرف کند؛ آزمایش را از نسخهٔ کوچک محلی شروع کنید، نه تمام لاگهای سرور زنده.
۶. مسیر مطالعهٔ مرتبط
- Raw Access و Visitors در سیپنل؛ خواندن لاگ دسترسی و پیدا کردن ربات مزاحم
- خطاهای سایت در سیپنل؛ بررسی لاگ و رفع خطای ۵۰۰ و ۴۰۳
۷. منابع و روش بررسی
منابع رسمی در ۲۴ اکتبر ۲۰۲۶ بررسی شدند. نمونههای فرمان با دادهٔ آموزشی در GNU/MSYS روی ویندوز بررسی شدهاند؛ این محیط، سرور لینوکس بومی نیست. رفتار مالکیت و دسترسی فایلسیستم باید روی سیستم مقصد جدا بررسی شود.